今日活动:
8个zfb口令红包共计50元
看看大家用哪个AI能回本w
(或者尝试自己解也行)
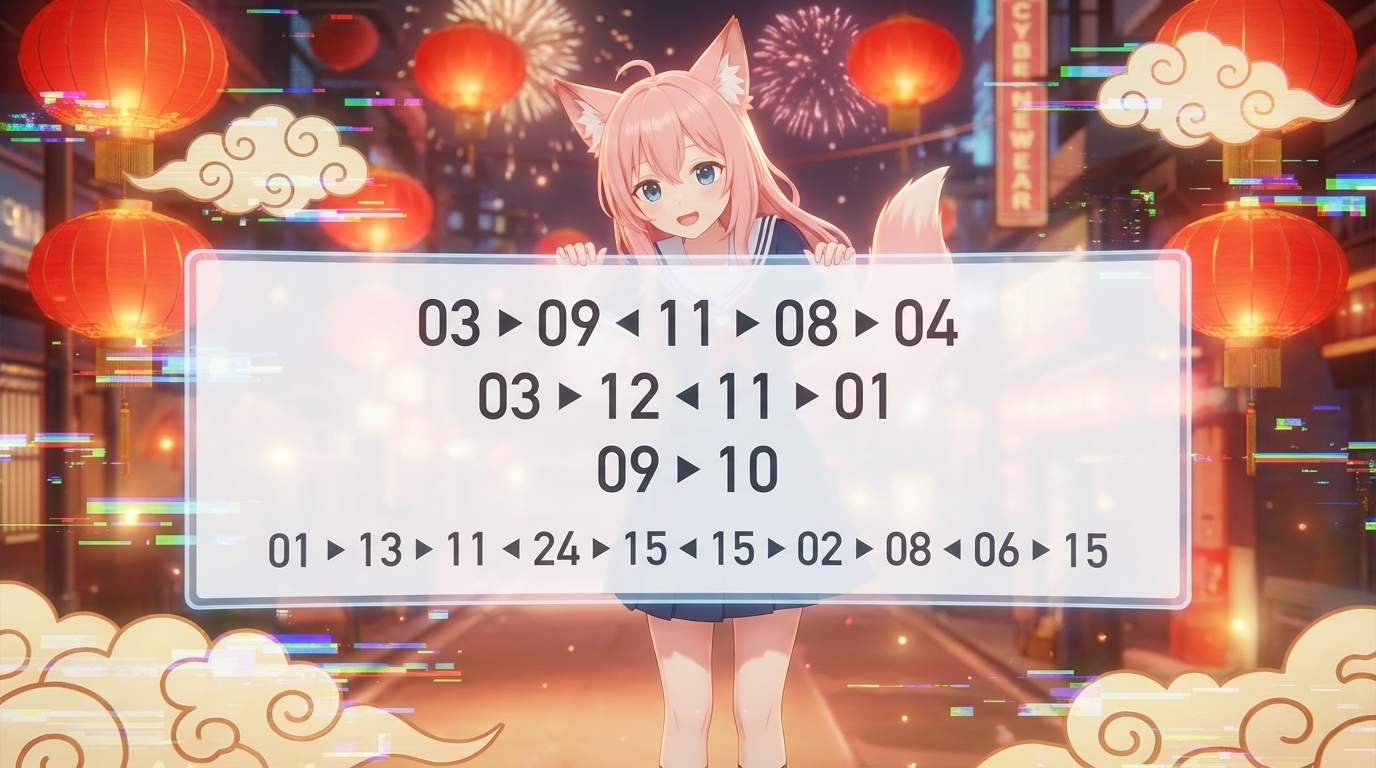
谜面在配图里,微博正文只有一句「今日活动」。图中是数字与方向箭头交替的序列,四行各自独立。
03 ▶ 09 ◀ 11 ▶ 08 ▶ 04 03 ▶ 12 ◀ 11 ▶ 01 09 ▶ 10 01 ▶ 13 ▶ 11 ◀ 24 ▶ 15 ◀ 15 ▶ 02 ▶ 08 ◀ 06 ▶ 15
把每行第一个数字当成起点,按 A=01、B=02 …… Z=26 的序号读。 之后每个数字给一次位移:▶ 是加,◀ 是减,算出的新序号再换回字母——一行就是一句话,四行之间不承接。 第 1 行 03 ▶09 ◀11 ▶08 ▶04 C → 3+9=12 L → 12−11=01 A → 1+8=09 I → 9+4=13 M 第 2 行 03 ▶12 ◀11 ▶01 C → 3+12=15 O → 15−11=04 D → 4+1=05 E 第 3 行 09 ▶10 I → 9+10=19 S 第 4 行 01 ▶13 ▶11 ◀24 ▶15 ◀15 ▶02 ▶08 ◀06 ▶15 (这一行留给你自己推) 前三行连起来是 CLAIM CODE IS,照同一套算法把第 4 行推完就是口令——在页面下方验证,这里不给答案。 难点不在算法,在于想到「数字是字母序号、箭头是加减」这一层——四组数字各自独立,不连成一条长链。
谜面就是这段代码的输出:把单词拆成字母序号做差,差为正写 ▶、为负写 ◀,数字就是两个字母之间要走的步数。注意 re.sub 会把空格剔掉,所以带空格的词组只能整块跑一次——四行谜面其实是跑了四次。 (代码里的 ▲ 0 分支对应相邻两个字母相同的情况,这一期没用到;原样附上。)
import re

def encrypt_word(word: str) -> str:
    if not isinstance(word, str) or not word:
        return "错误:请输入一个有效的单词。"

    cleaned_word = re.sub(r'[^A-Z]', '', word.upper())

    if not cleaned_word:
        return "错误:输入中不包含任何英文字母。"

    result_parts = []
    try:
        prev_num = ord(cleaned_word[0]) - 64
        result_parts.append(str(prev_num))
    except IndexError:
        return ""

    for i in range(1, len(cleaned_word)):
        current_char = cleaned_word[i]
        previous_char = cleaned_word[i-1]

        if current_char == previous_char:
            result_parts.append("▲ 0")
            continue

        current_num = ord(current_char) - 64
        difference = current_num - prev_num

        if difference > 0:
            result_parts.append(f"▶ {difference}")
        elif difference < 0:
            result_parts.append(f"◀ {abs(difference)}")

        prev_num = current_num

    return " ".join(result_parts)

print(encrypt_word("TIME"))8 个支付宝口令红包,共 50 元。这一期没有另发复盘微博;博文当时转发 2、评论 8、点赞 7。 正文写的是「看看大家用哪个 AI 能回本」,所以从一开始就是拿 AI 当解谜对手在做的。
直接粘进来即可,大小写与多余空白会被自动忽略