zfb的8位数字口令红包,20份。
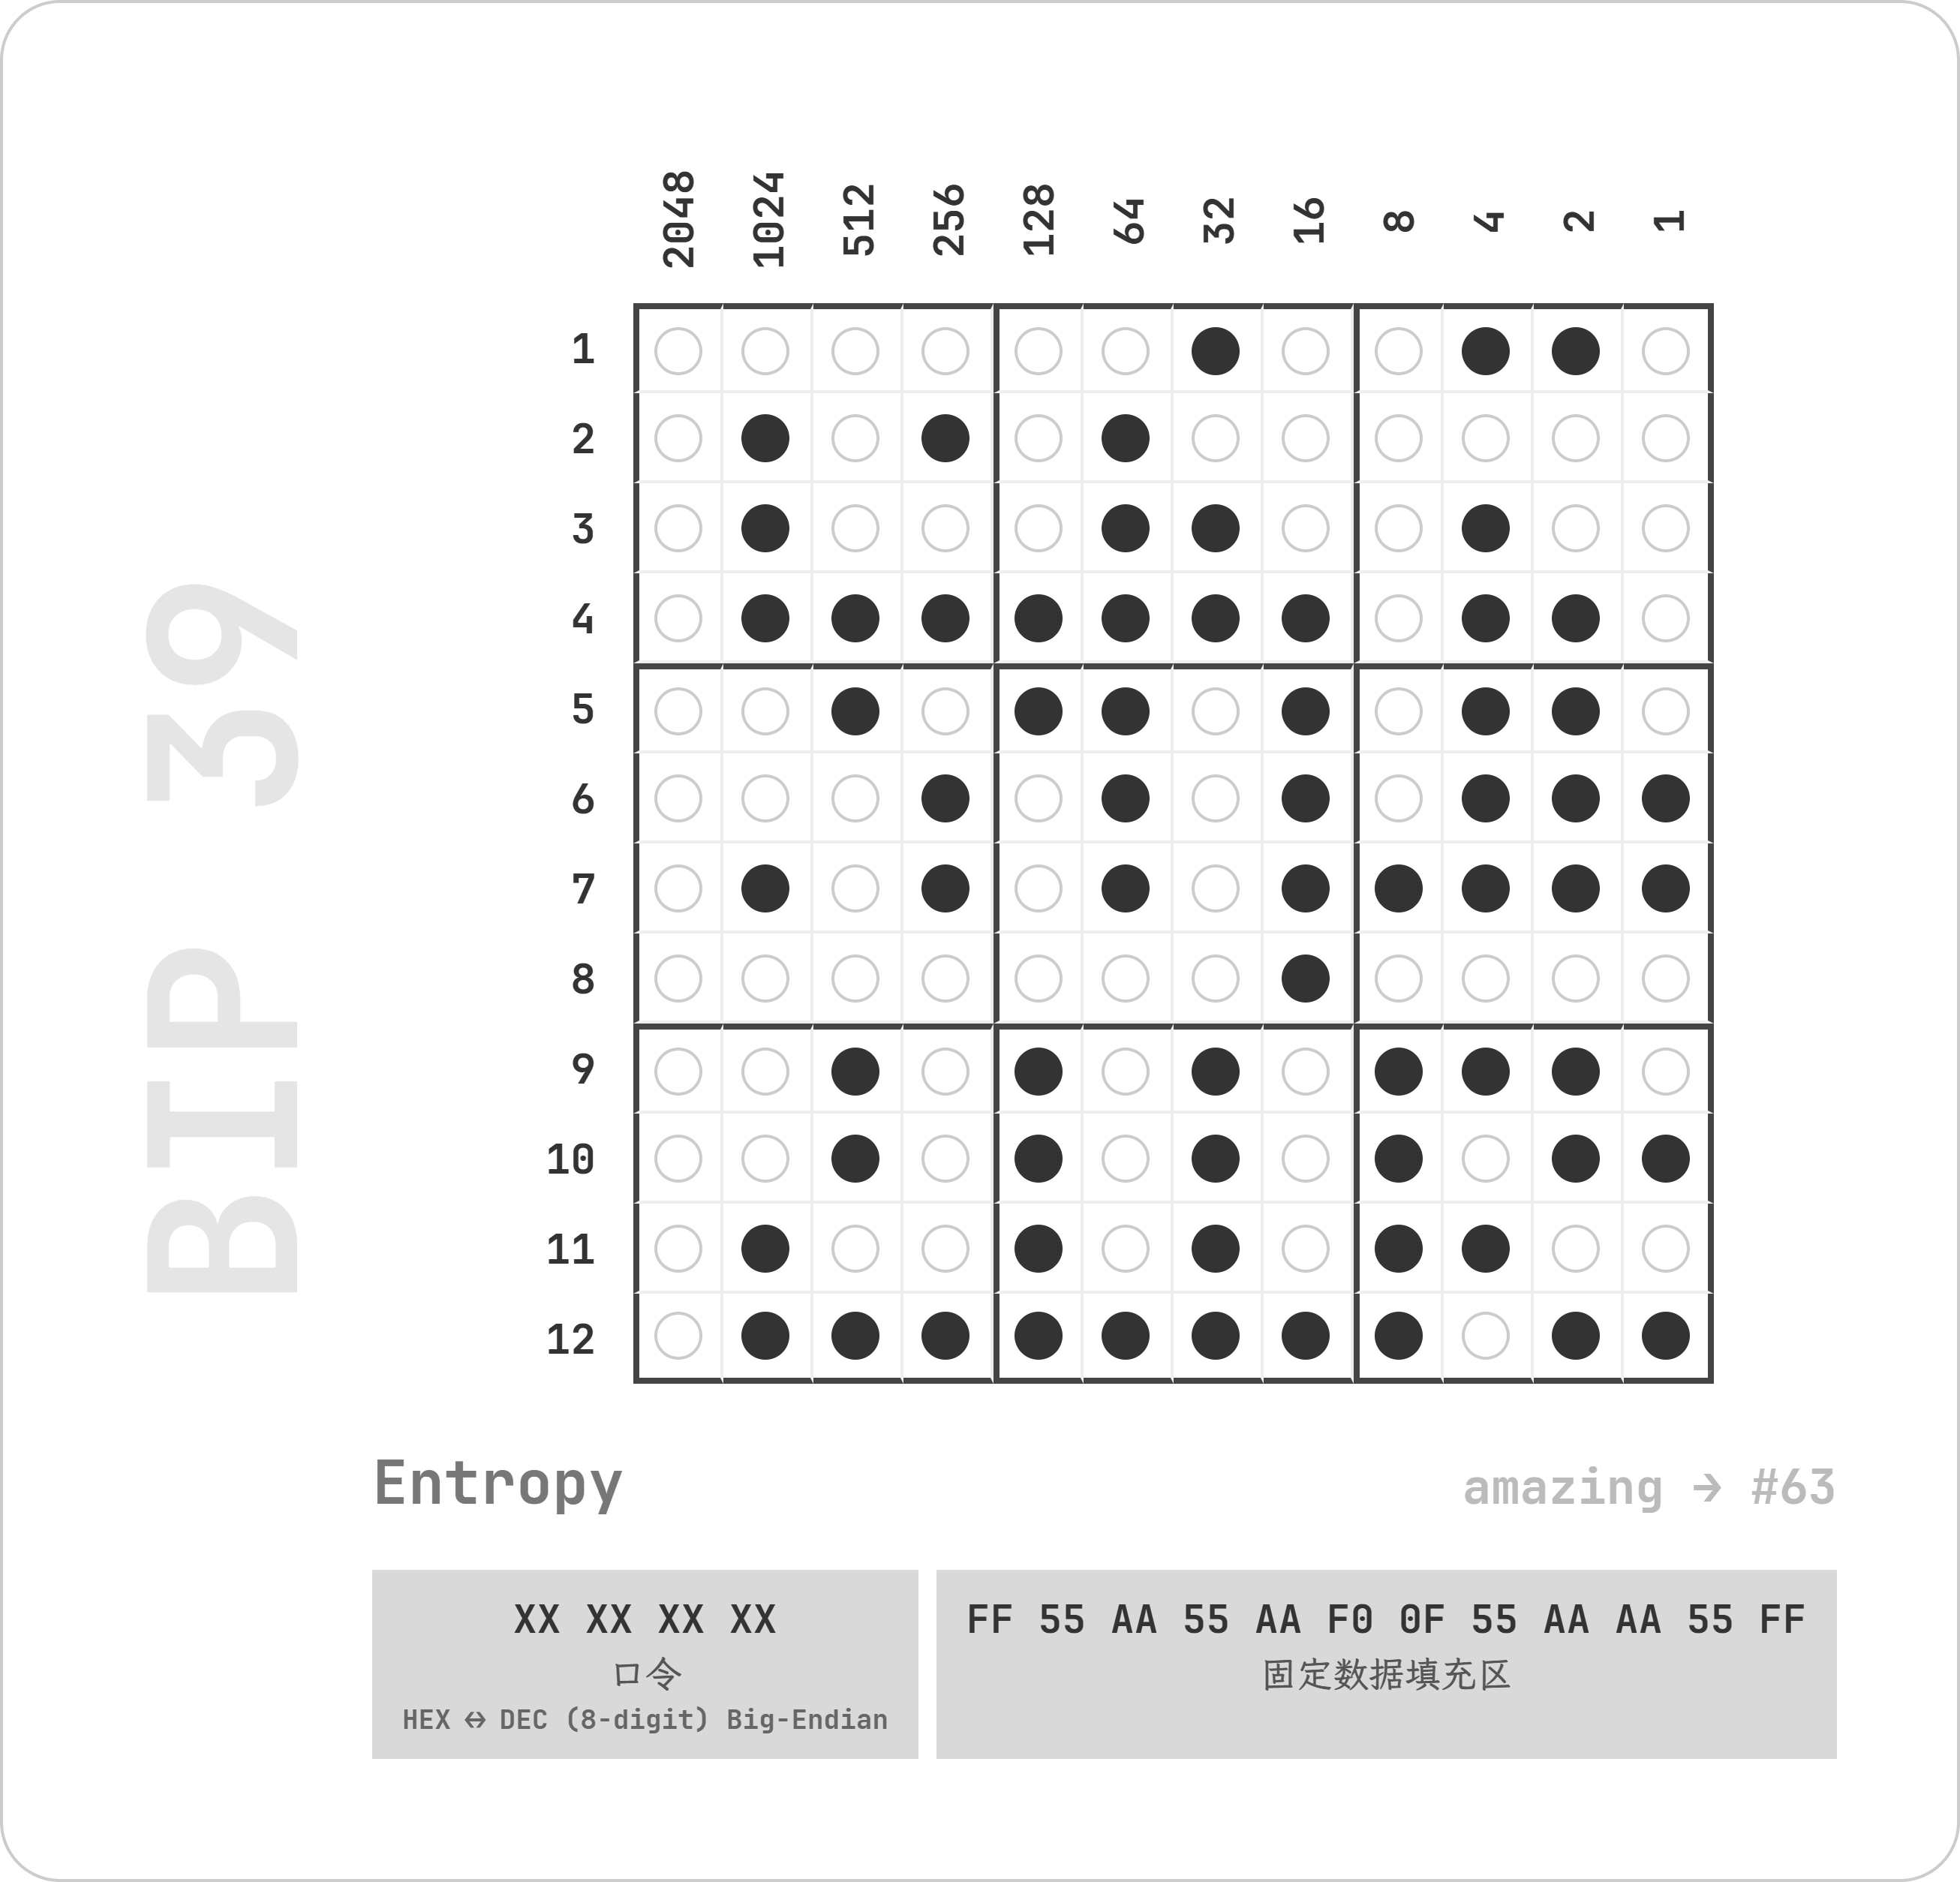
两题共用同一套谜面结构:12×12 的圆点棋盘格,横坐标 2048/1024/…/2/1,纵坐标 1~12,旁边一枚 BIP39 水印。黑点为 1、空心为 0,每行读出 12 bit —— 但那不是数值,是 1-based 的词编号。 第一题只用到前 4 列对应的 32 bit;第二题附了一份 Guidelines,把整条链路写死在图上。
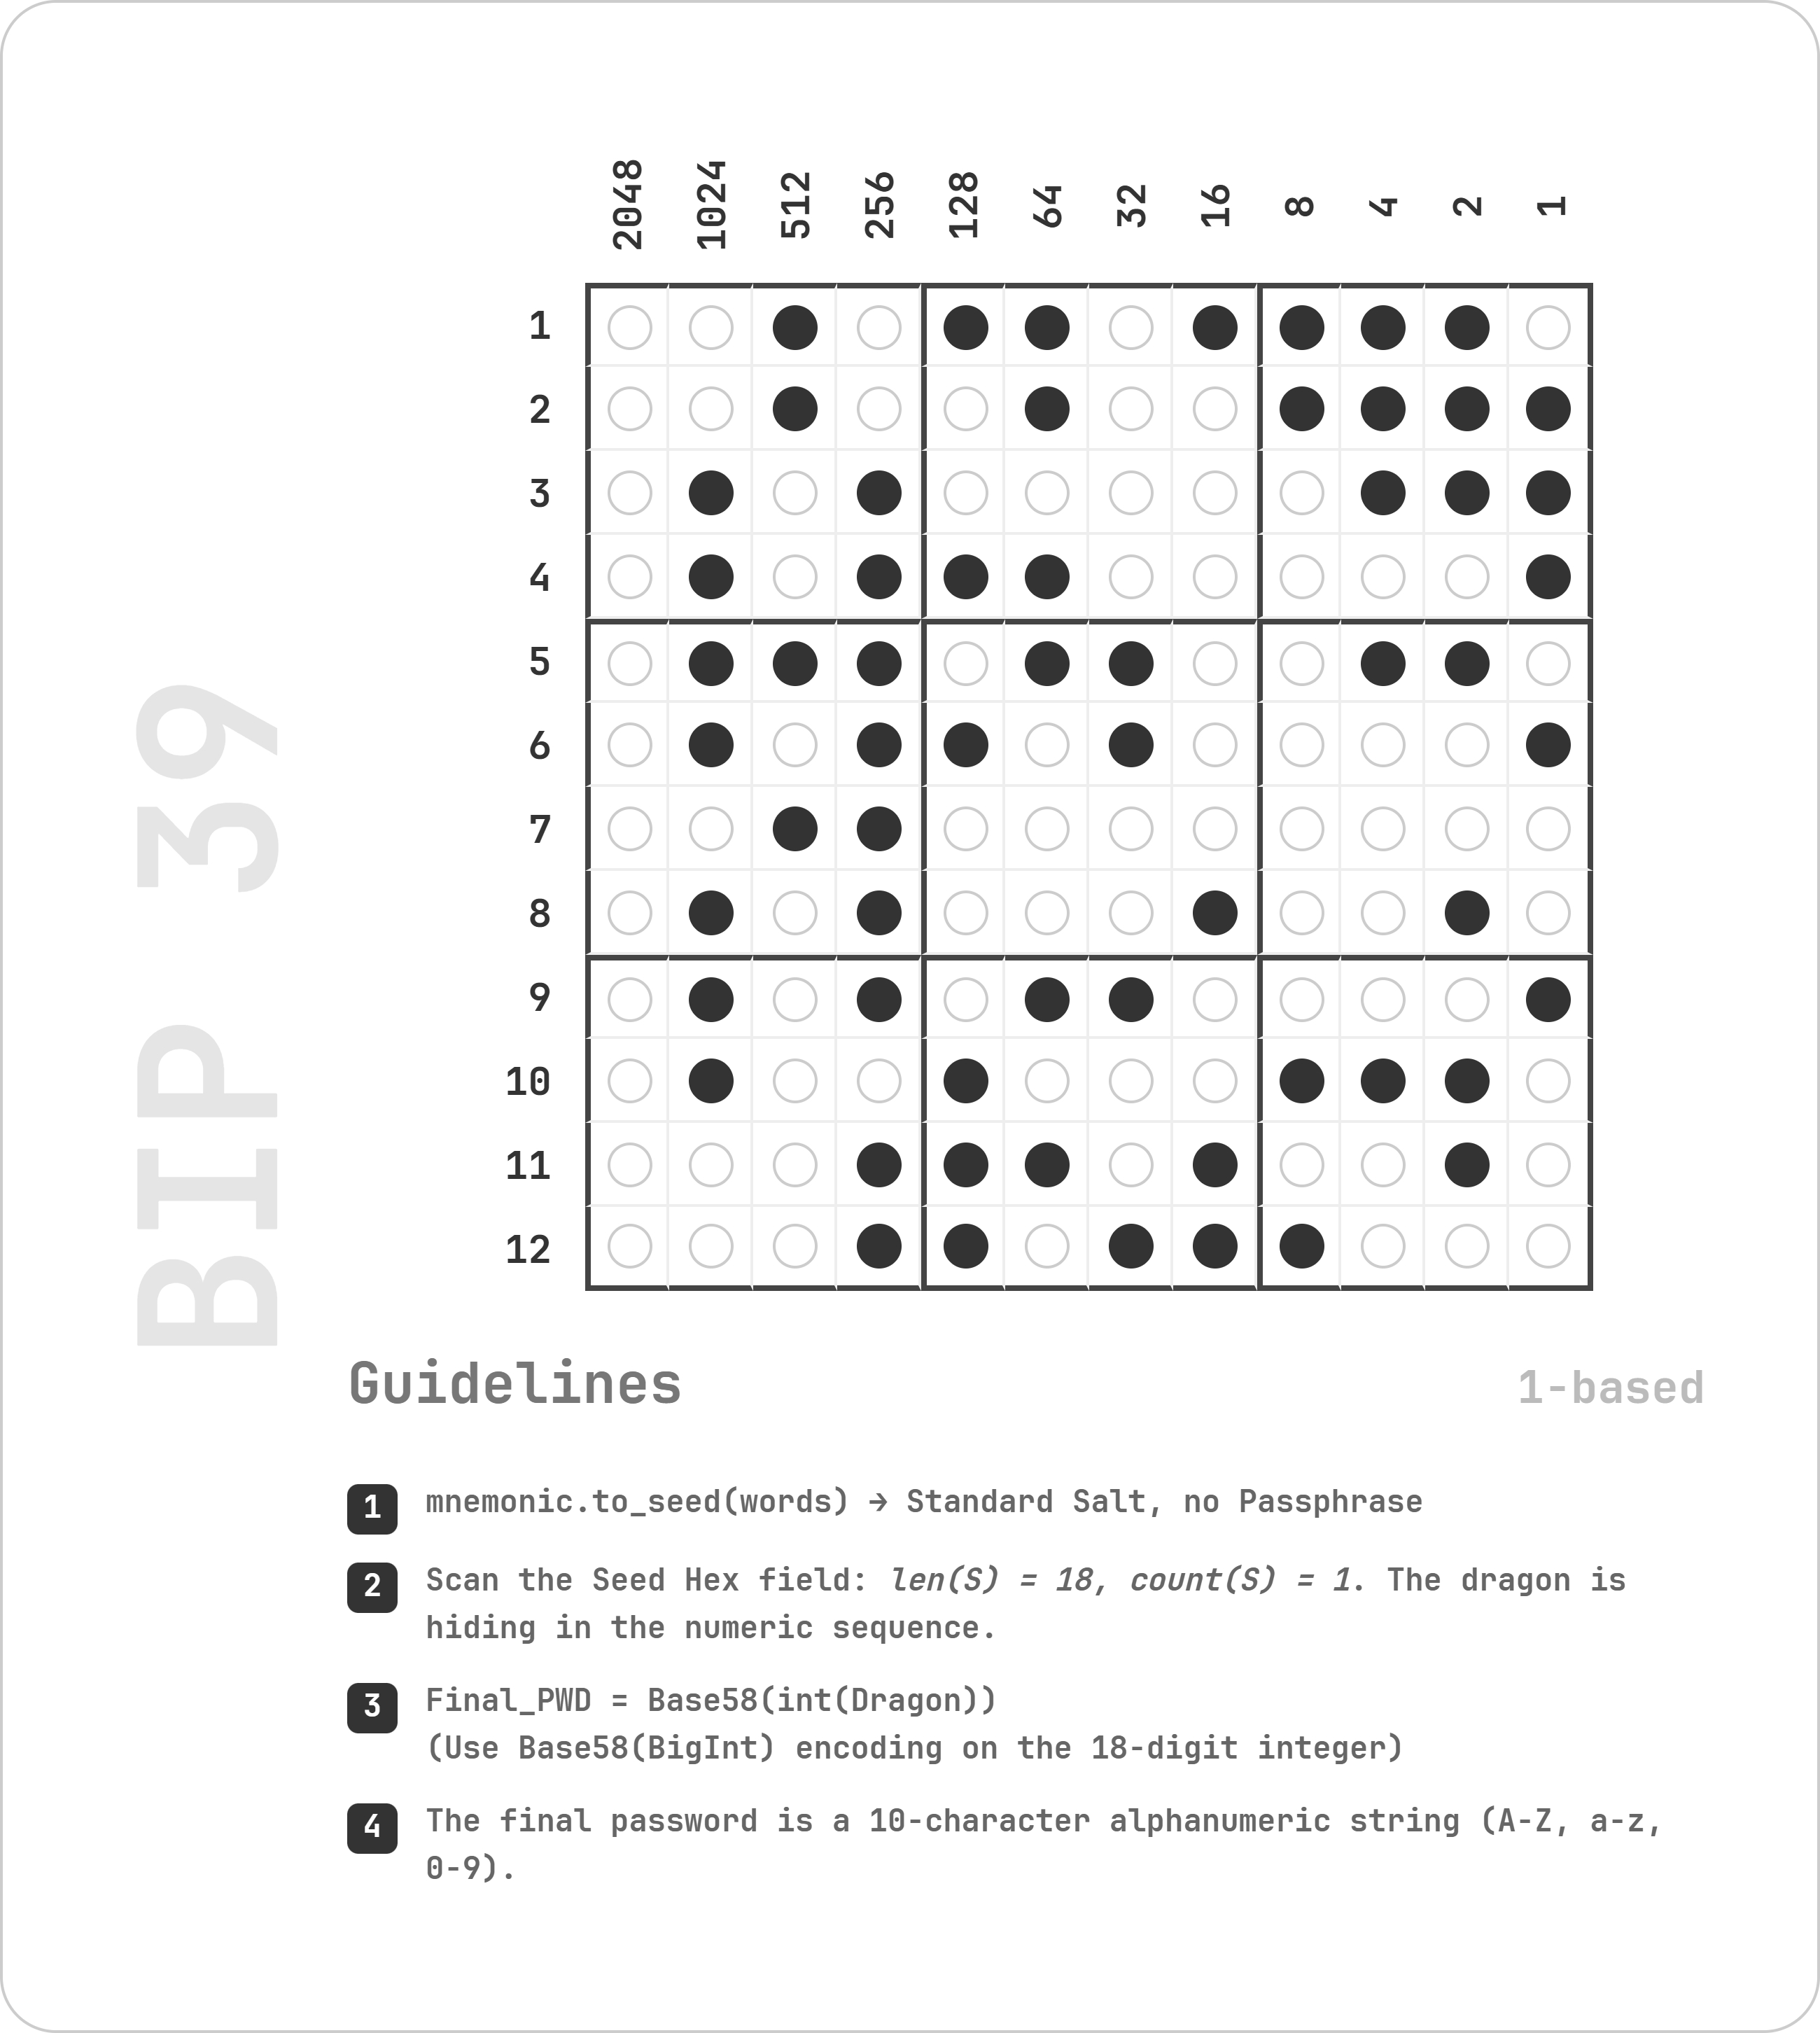
每行 12 格,从左到右权重是 2048、1024、512、256、128、64、32、16、8、4、2、1,黑点为 1。把一行读成一个 12 bit 数之后,关键的一步是:减去 1 才是 BIP39 的词索引。 图上写着 1-based(第一题角落那行 amazing → #63 就是提示:BIP39 词表里 0-based 是 62、1-based 才是 63)。因为 1-based 编号要到 2048,才需要第 12 根「2048」支柱——12 列是这么来的。 12 个索引各取 11 bit 拼成 132 bit,按 BIP39 的规矩拆成「前 128 bit = Entropy、后 4 bit = 校验位」,校验位应当等于 SHA256(Entropy) 的头 4 个 bit。这一条可以自证读得对不对。
#!/usr/bin/env python3
"""从 BIP39「冷钱包雕版」棋盘格图里读出 12 个助记词索引。

棋盘格是 12×12 的圆点阵:横轴权重 2048/1024/…/2/1,纵轴行号 1~12,
实心圆 = 1、空心圆 = 0。每行读成一个 12 bit 数,减去 1 才是 BIP39 词索引
(雕版是 1-based 的:index 0 也要刻一格,否则分不清「没刻」和「0 号词」)。
12 个索引各取 11 bit 拼成 132 bit = Entropy(128 bit) + 校验位(4 bit),
校验位应等于 SHA256(Entropy) 的头 4 bit —— 脚本用它自证读对了没有。

依赖:numpy, pillow
用法:
    python read_grid.py 谜面图.jpg
    python read_grid.py 谜面图.jpg --x0 899.5 --y0 459.5 --step 120 --win 20
"""
import argparse
import hashlib
import sys

import numpy as np
from PIL import Image

GRID = 12


def line_centers(dark, axis):
    """找出棋盘上「每 4 列/行一组」的分组粗线中心"""
    proj = dark.sum(axis=1) if axis == 0 else dark.sum(axis=0)
    limit = (dark.shape[1] if axis == 0 else dark.shape[0]) * 0.4
    idx = np.where(proj > limit)[0]
    out, start, prev = [], None, None
    for i in idx:
        if start is None:
            start = prev = i
            continue
        if i > prev + 5:
            out.append((start + prev) / 2)
            start = i
        prev = i
    if start is not None:
        out.append((start + prev) / 2)
    return out


def calibrate(path):
    """只用分组线推格距;原点由第一条线外推半格(线的渲染宽度会引入偏差,故留 --x0 可覆盖)"""
    a = np.array(Image.open(path).convert("L")).astype(np.int32)
    dark = a < 128
    rows, cols = line_centers(dark, 0), line_centers(dark, 1)
    if len(rows) < 2 or len(cols) < 2:
        sys.exit("✗ 没找到棋盘的分组线,请用 --x0/--y0/--step 手工指定")
    ystep = float(np.median(np.diff(rows)) / 4)
    xstep = float(np.median(np.diff(cols)) / 4)
    # 第 0 行/列的圆心:第一条分组线在格子的边界上,圆心在它 + 半格处
    y0 = rows[0] + ystep / 2
    x0 = cols[0] + xstep / 2
    return a, x0, y0, xstep, ystep


def read_bits(a, x0, y0, xstep, ystep, win):
    h = win // 2
    m = np.zeros((GRID, GRID), dtype=int)
    for j in range(GRID):
        for i in range(GRID):
            cx = int(round(x0 + xstep * i))
            cy = int(round(y0 + ystep * j))
            patch = a[cy - h:cy + h, cx - h:cx + h]
            m[j, i] = 1 if patch.mean() < 128 else 0
    return m


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("image")
    ap.add_argument("--x0", type=float, default=None, help="第 0 列圆心 x")
    ap.add_argument("--y0", type=float, default=None, help="第 0 行圆心 y")
    ap.add_argument("--step", type=float, default=None, help="格距(横纵相同)")
    ap.add_argument("--win", type=int, default=20, help="采样窗口边长")
    args = ap.parse_args()

    a, x0, y0, xstep, ystep = calibrate(args.image)
    x0 = args.x0 if args.x0 is not None else x0
    y0 = args.y0 if args.y0 is not None else y0
    if args.step:
        xstep = ystep = args.step

    m = read_bits(a, x0, y0, xstep, ystep, args.win)
    print(f"网格: x0={x0:.1f} y0={y0:.1f} step={xstep:.2f}")
    print()
    for j in range(GRID):
        print("  行%2d  %s  %s" % (j + 1, "".join("●" if v else "·" for v in m[j]),
                                   "".join(str(v) for v in m[j])))

    vals = [int("".join(str(v) for v in m[j]), 2) for j in range(GRID)]
    idx = [v - 1 for v in vals]
    print()
    print("  12bit 刻度值:", vals)
    print("  词索引(减1) :", idx)
    if any(not (0 <= i < 2048) for i in idx):
        sys.exit("✗ 有索引越界,说明读错了(可能列序反了或采样偏了)")

    bits = "".join(f"{i:011b}" for i in idx)
    ent = f"{int(bits[:128], 2):032X}"
    ck = bits[128:]
    want = f"{int(hashlib.sha256(bytes.fromhex(ent)).hexdigest()[0], 16):04b}"
    print("  Entropy(hex) :", ent)
    print("  末 4 bit     :", ck, "| SHA256(Entropy) 前 4 bit:", want,
          "->", "✓ 读法自洽(这是一份合法 BIP39 助记词)" if ck == want else "✗ 不自洽,读错了")


if __name__ == "__main__":
main()读出 12 个索引、还原出 128 bit 的 Entropy 之后,谜面右下角的提示框已经把话说完了:左边一格写着「XX XX XX XX / 口令 / HEX ⇔ DEC (8-digit) Big-Endian」,右边一格写着「FF 55 AA 55 AA F0 0F 55 AA AA 55 FF / 固定数据填充区」。 意思是:Entropy 的前 4 个字节是口令区,后 12 个字节是出题时填充的固定数据。把前 4 字节按大端当整数读出来,转成 8 位十进制,就是口令。 他后来复盘时说这一题不完美也在这里:后 12 字节是死数据,解题人只要读出前 32 bit 就能拿到口令,连 BIP39 词表都不必查。完整推导在他 2 月 6 日那条复盘微博里。
第二题的棋盘格布局完全一样,但口令不再放在 Entropy 里。图上的 Guidelines 把链路写死了: 1. mnemonic.to_seed(words),标准盐值、无 passphrase; 2. 扫描 Seed 的十六进制字段,找长度恰好 18 的数字串,且全场只有一条; 3. Final_PWD = Base58(int(Dragon)); 4. 口令是 10 位字母数字串。 三个坑都在细节里:
按这四条走完,得到的 10 位串就是这一期第二个红包的口令。
prove.closeai.moe 是他当年写的无后端验证页:页面上没有口令、也没有口令的哈希,只有两段十六进制密文。 原理是把「口令当密钥」反过来用:KEY = SHA256(输入的口令),用它 AES-GCM 解密那段密文;解密成功(GCM 认证标签通过)且明文等于 SUCCESS_VERIFIED,才算对。 它现在依然在线、依然能用,两题的答案都能在上面点出来。代价是它没有做任何归一化——大小写、全角、多余空格都会直接判错,这也是本站做了归一化的原因。
第一个红包 88.88 元 / 20 份,4 小时内被抢光;第二个红包 200 元 / 10 份,2 小时内被抢光。 第 1 题发出三小时后,他在第二题的微博里提了一句进度:上一个红包已有 13/20 破译。
第 1 题 · 88.88 元 / 20 份(2026-02-05 19:39 发布)
8 位纯数字,随便带空格或全角都不影响
第 2 题 · 200 元 / 10 份(2026-02-05 22:09 发布)
10 位字母数字,大小写敏感(当年那个验证工具就区分大小写)