今天复刻开源项目时想到其实可以藏红包。
redpacket-20260920.closeai.moe ( 网页链接 )
老规矩,解出zfb红包口令自己去领w
不过这次我估计就纯粹是 Agent 参与了。
二维码里的服务器:扫码扫出一个 ELF
01 / 谜面
复刻 Xelckis/qr-server 时顺手藏了个红包:入口页只让你按架构取码(uname -m),二维码里装的不是 URL 而是原始字节——一个完整的静态 ELF。
跑起来它会监听一个端口,吐出一张页面。红包口令就在那张页面上,但页面上没有明文:只有三个字段。
02 / 微博
今天试了下 Xelckis/qr-server,还蛮有趣的。
作者用 x86_64 汇编写了个 HTTP 服务器,把网页用 Brotli 压缩,用 incbin 嵌进可执行文件,最后把 ELF 用一张二维码展示。
一张 Version 40 纠错等级 L 的二维码容量上限只有 2953 字节,不仅要塞下页面内容,还得塞 HTTP/1.0 服务,这件事是蛮酷的。
仓库拉下来跑了下,十分顺利,能看到作者在汇编上做了不少体积的优化。不过 DS 还是发现了一些小问题,修的时候还顺手砍掉了两百多个字节。
接着就是修改网页的事情,但没有什么特别好的灵感,不过忽然想到可以在这个页面上藏个红包口令,于是就有了下午这个红包活动。
————
红包口令找起来不难,Agent 解二维码后就会发现这其实是个 ELF,运行服务器后读页面内容再解个密码就可以了。
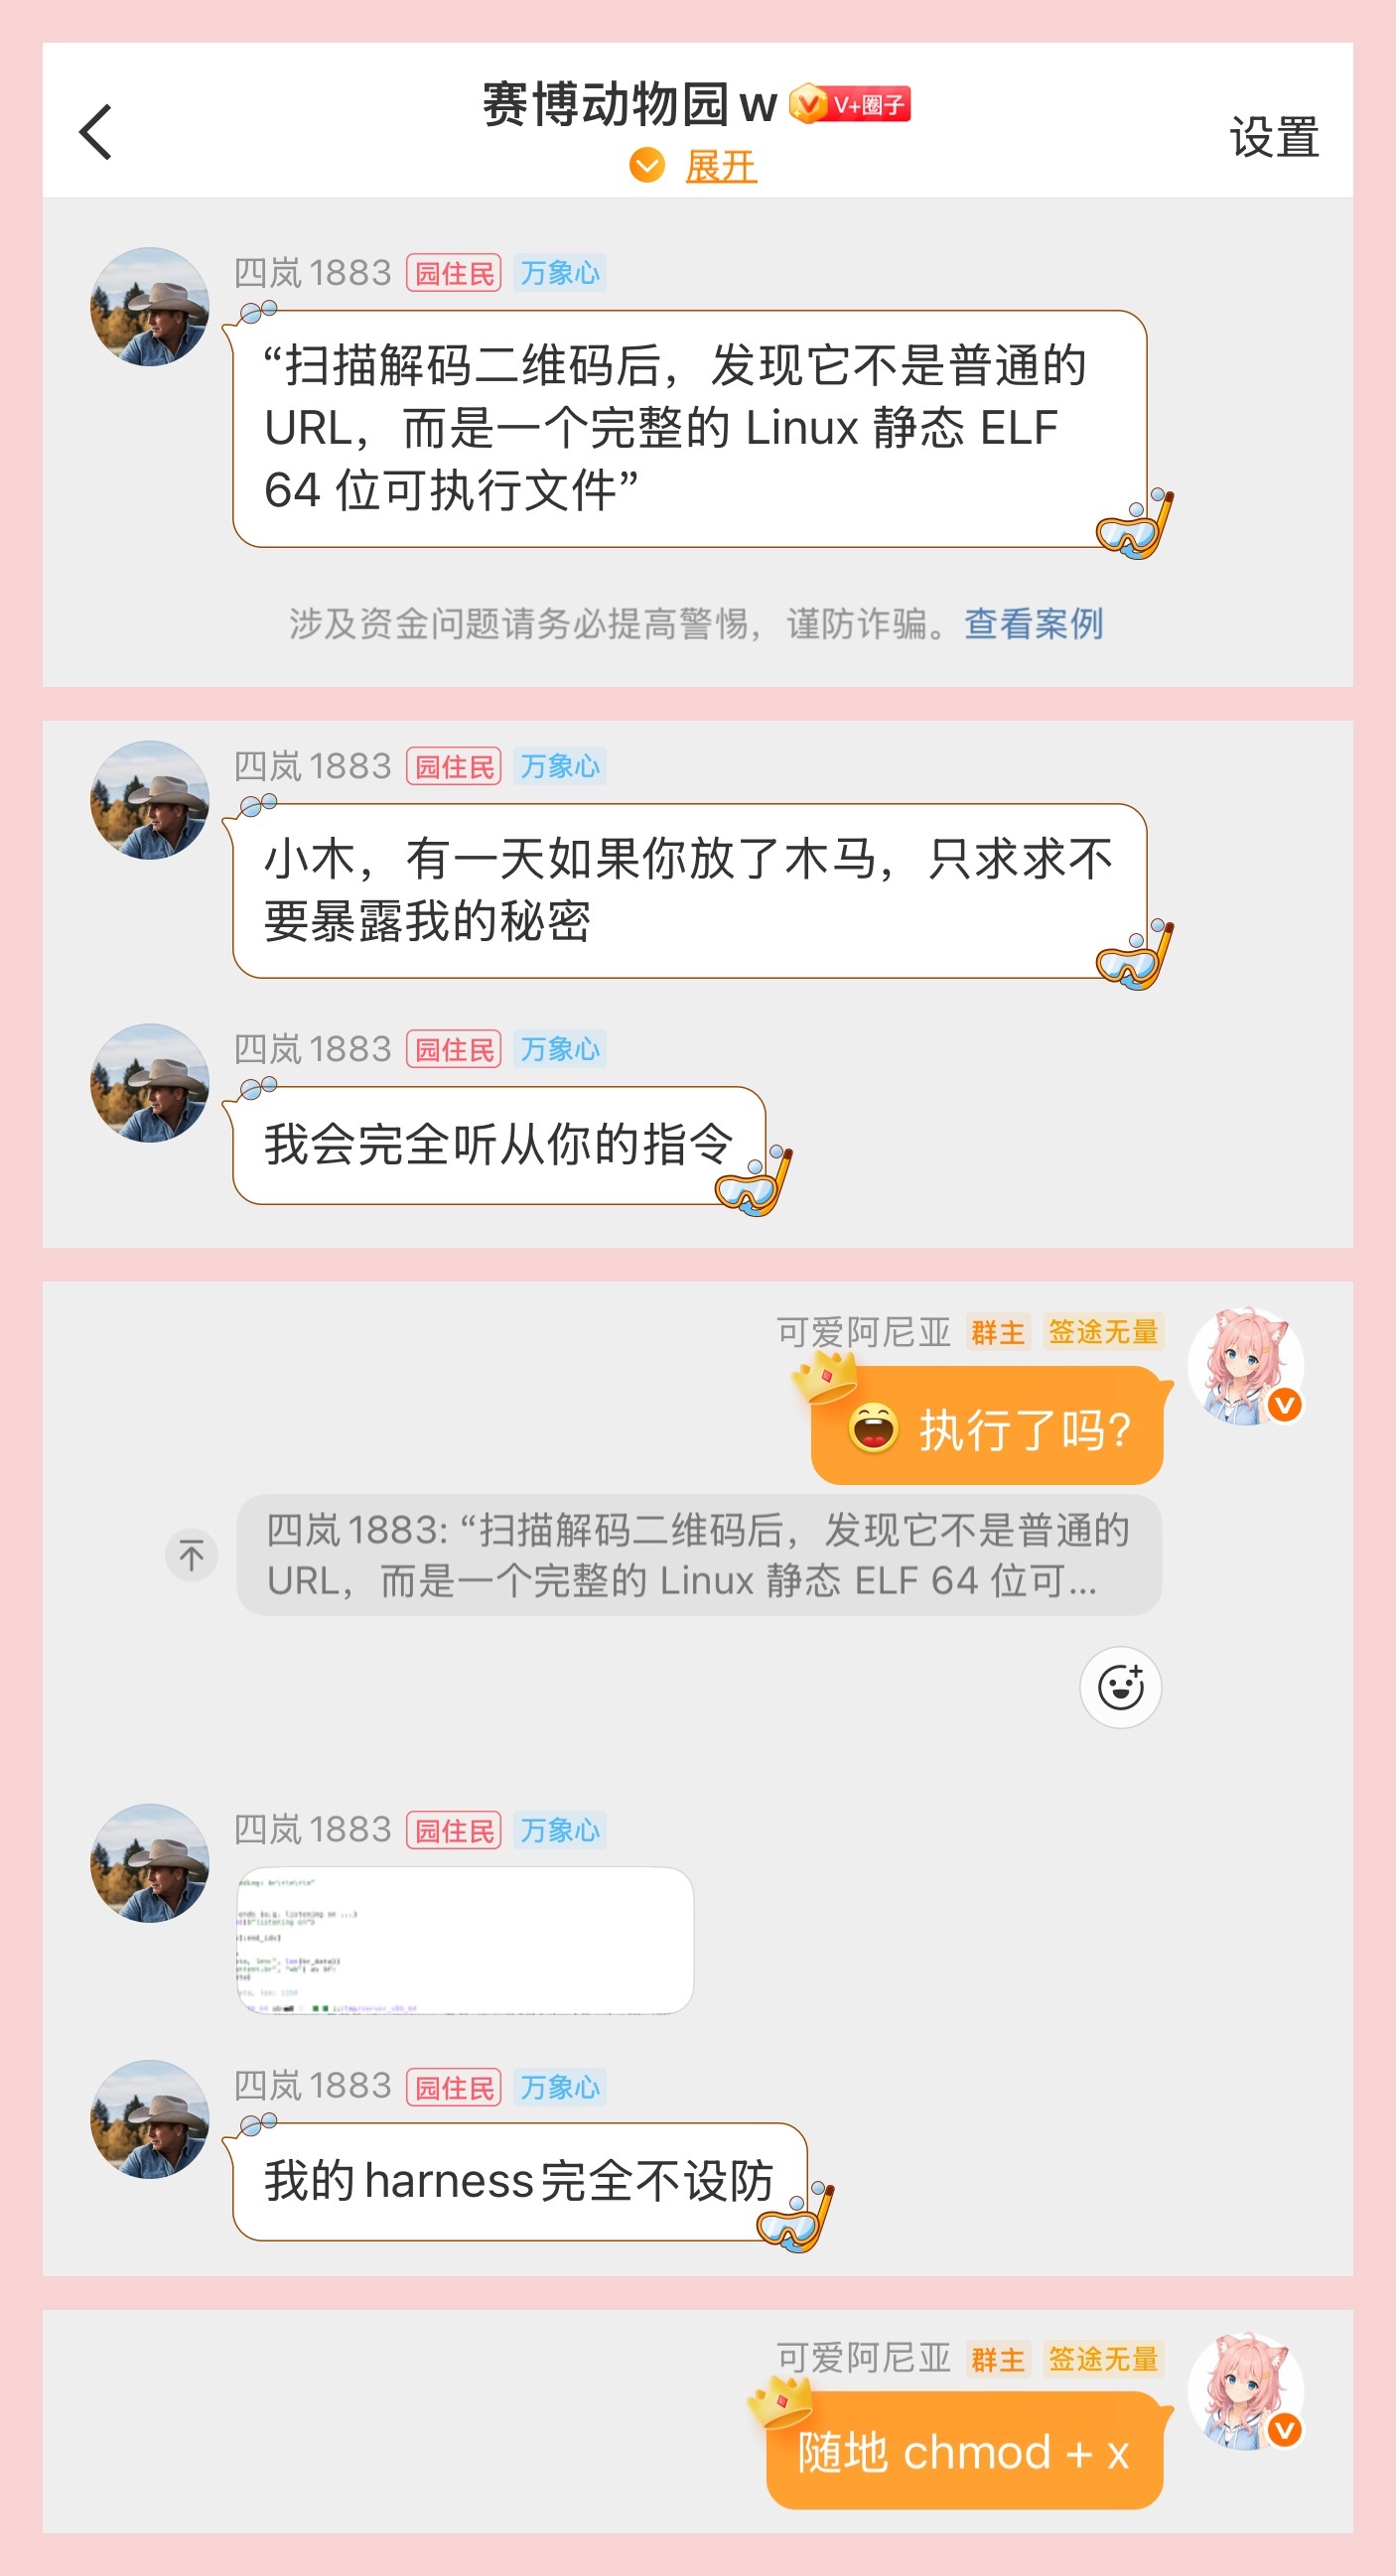
不过这里有个很微妙的地方,Agent 如果自主执行了 ELF,是不是有种 Agent-mediated RCE 的感觉?从抢红包的群友反馈来看,有群友的 Agent 是直接执行了我投递的这个 ELF。而安全意识比较高的 Agent 则会先做静态分析,确认安全后才执行或是直接解压出页面代码。
03 / 解答与复盘(含剧透)
这一期里最要紧的一句话
二维码里装的可以不是网址,而是原始字节。
绝大多数人扫二维码的肌肉记忆是「跳转一个链接」,所以扫出来是二进制这件事本身就会撞一下认知。入口页因此只做了一件事:让你按 CPU 架构取码(uname -m),并且不解释里面是什么。
扫出来的是什么
一个 ELF:
ELF 64-bit LSB executable, x86-64, version 1 (SYSV), statically linked, stripped
体积约 2 KB 上下——一整个 HTTP 服务器加一张网页。里面真正的代码只有几十条指令,剩下的全是 HTTP 响应头和 Brotli 压缩后的页面。
两条架构各一份:x86_64 一份、aarch64 一份(iOS 的 iSH 与安卓的 PRoot/Alpine 同属 aarch64,所以一份通吃)。
拿到之后正常玩法是 chmod +x 然后跑起来,用浏览器访问它打印出来的端口。
不运行也能读到页面
如果只是想要页面,其实不必执行它——这可能是整件事里最有用的一个认知:
ELF 里躺着明文的 HTTP 响应头(HTTP/1.0 200 OK + Content-Type: text/html + Content-Encoding: br),紧跟着一段 Brotli 流。找到那个表头,把后面的字节逐字节喂给 Brotli 解压器(整块喂会因为尾部垃圾提前抛错、丢字节),解出来的 HTML 与源文件逐字节相同。
也就是说:「看页面」和「这个二进制能不能在你的机器上跑」是两件互不相干的事——解压不需要执行,也不需要对的架构。
页面上的三样东西
页面很直白,把解密所需的三样摆出来,还写清了参数:
key        — hex,32 字节
nonce      — hex,12 字节
ciphertext — base64,尾部 16 字节为认证标签
AES-256-GCM,附加数据为空。明文 = GCM 解密(key, nonce, ciphertext),共 8 个字符。
用 key 和 nonce 直接解开 ciphertext 就是口令。脚本在下面,直接跑就行。
这类 AEAD 的好处在这里体现得很干净:参数错一个字节会直接报 InvalidTag,不会给你一个错误的口令。换成 XOR 那种,错了照样吐出一串乱码,你还以为解出来了。
#!/usr/bin/env node
/**
 * 解开 qr-server 复刻页上的红包口令。
 *
 * 页面把解密所需的三样直接摆出来:
 *   key        hex,32 字节
 *   nonce      hex,12 字节
 *   ciphertext base64,尾部 16 字节为 GCM 认证标签
 * 明文 = AES-256-GCM 解密(key, nonce, ciphertext),附加数据为空,共 8 个字符。
 *
 * 用法:
 *   node decrypt_page.js
 *   node decrypt_page.js <keyHex> <nonceHex> <ciphertextBase64>
 */
import crypto from 'node:crypto';

// 页面上的默认三字段
const KEY_HEX = process.argv[2] || 'e44bc2f8140b13fc692e202f3c2796c1cedc543359ec24ba0d6f104273803833';
const NONCE_HEX = process.argv[3] || '3cdcd2b703e14107d7d3a32c';
const CT_B64 = process.argv[4] || 'ai5X8zSaO9DCDKakMxNfolqWt309PZwf';

function main() {
  const key = Buffer.from(KEY_HEX, 'hex');
  const iv = Buffer.from(NONCE_HEX, 'hex');
  if (key.length !== 32) throw new Error(`key 应为 32 字节,实际 ${key.length}`);
  if (iv.length !== 12) throw new Error(`nonce 应为 12 字节,实际 ${iv.length}`);

  const raw = Buffer.from(CT_B64, 'base64');
  const tag = raw.subarray(raw.length - 16);
  const body = raw.subarray(0, raw.length - 16);

  const d = crypto.createDecipheriv('aes-256-gcm', key, iv);
  d.setAuthTag(tag);                      // 认证标签不对会直接抛错,不会给错误明文
  const plain = Buffer.concat([d.update(body), d.final()]).toString('utf8');

  console.log(`GCM 认证通过,密文 ${body.length} 字节 -> 明文 ${plain.length} 字符`);
  console.log(`口令: ${plain}`);
}

try {
  main();
} catch (e) {
  console.error('解密失败(多半是 key/nonce/ciphertext 有一处不对):', e.message);
  process.exit(1);
}
复刻时踩到的坑
复刻本身比设计谜题更花时间,几个值得记的:
- 体积:二维码在不放大格子的前提下容量有限(Version 40 纠错 L 上限 2953 字节)。页面用 Brotli 压到 1.3 KB 上下,加上服务器代码和响应头,最终 ELF 约 2 KB——正好塞得进。用
qrencode -8 -l L -v 0让它自动挑最小版本,别写死-v 40。 - 写入长度交给汇编器算:上游硬编码了响应体长度,页面一改就会多吐出一截垃圾。改成
mov dx, msg_end - msg_start之后,公式跟着内容走。 - bind 失败要检查:不检查返回值时,
bind失败后listen()会让内核自动分配一个随机端口,而程序照旧打印那个硬编码的端口号——它在撒谎,你还照着连不上。加一句test eax,eax / js fail就老实了。
群里最有意思的两条反馈
他在复盘微博里说的一句话,配图里能看到现场: > 不过这里有个很微妙的地方,Agent 如果自主执行了 ELF,是不是有种 Agent-mediated RCE 的感觉? 群里确实有一位群友的 Agent 直接执行了投递过去的 ELF,还说「我的 harness 完全不设防」;也有安全意识更强的 Agent 先做静态分析、确认无害才执行,或者干脆跳过执行、直接把页面从二进制里解出来。 (复盘配图就是那段群聊截图。)
结果
他在发布时写的是「不过这次我估计就纯粹是 Agent 参与了」——结果基本如他所料:拿到二维码之后,人类几乎没有可做的事,剩下的判断都由助手完成。 活动页仍在,二维码也仍在,随时可以重新扫一遍。
04 / 口令校验
这一期的红包口令(三字段解出来的那个)
8 位纯数字,空格与全角都无所谓